
Recurso
Uma IA que lê seu dispositivo antes de responder
Conecte um dispositivo e a IA lê primeiro sua configuração e depois responde por esse dispositivo – suas interfaces reais, endereços e versão RouterOS – em vez de um exemplo genérico. Você obtém uma explicação simples, detalhes técnicos e um script editável. O assistente nunca executa nada: você mesmo revisa o script e o executa.

A diferença: viu este dispositivo
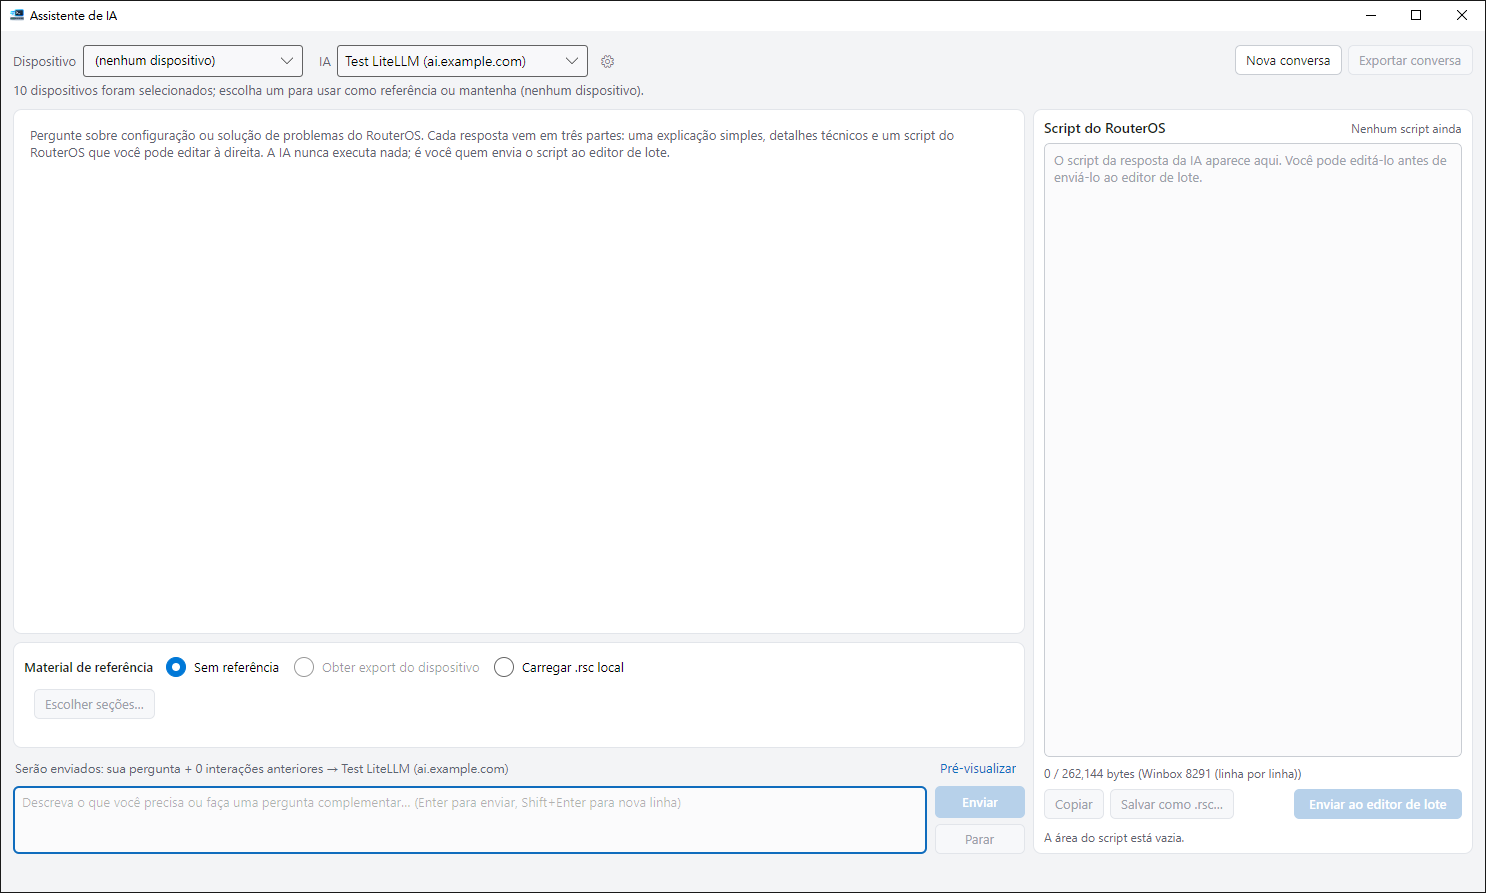
Abra o Assistente de IA no lado direito da tela inicial ou pressione Ctrl+I. Seu menu ▾ abre as configurações de conexão AI. Várias janelas do assistente podem ser abertas, sem nenhum dispositivo de referência ou com um instantâneo de exportação de configuração do dispositivo.
- Ele vê este dispositivo: um
/exportsomente leitura, sem nenhum arquivo criado no dispositivo; você escolhe quais seções serão enviadas. - Conhece a versão: informa se o dispositivo executa RouterOS 6 ou 7 e escreve comandos para ele.
- Um script que você pode verificar: o script à direita pode usar os nomes de interface deste dispositivo e carrega um nível de risco; quando parecer certo, escolha Enviar para editor em lote.
Seu serviço de IA, sua chave
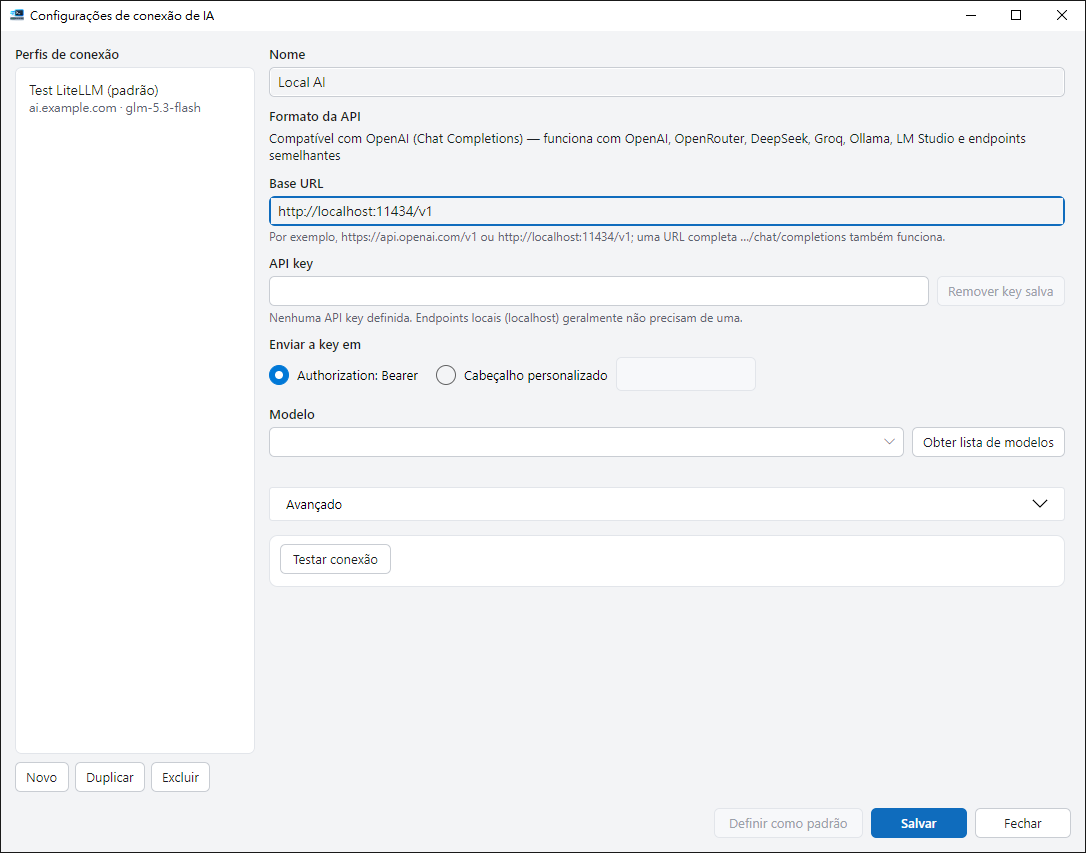
RosRunner não inclui um serviço de IA próprio e não possui endpoint integrado. Você cria um perfil de conexão AI — um URL base, um modelo e, para a maioria dos serviços em nuvem, uma chave API — e o assistente envia suas perguntas para lá e para nenhum outro lugar. O aplicativo não envia telemetria.
Esta versão suporta um formato API: Chat Completions compatível com OpenAI. É oferecido por serviços como OpenAI, OpenRouter, DeepSeek, Groq e Mistral, e por runtimes locais como Ollama, LM Studio e vLLM, onde o modelo roda em seu próprio computador e nenhuma chave é necessária. Um perfil também pode nomear um cabeçalho de chave diferente, adicionar cabeçalhos extras e uma cadeia de consulta, apontar para uma URL de lista de modelos separada e mesclar campos de solicitação extras (um objeto JSON) no corpo da solicitação, para pontos de extremidade como gateways Azure OpenAI, Ollama e API que os esperam. Esforço de raciocínio (enviado como reasoning_effort, Baixo para novos perfis) evita que os modelos de raciocínio pensem mais do que a pergunta precisa. Os serviços mencionados aqui são exemplos do formato, não uma lista de compatibilidade testada.
Testar conexão verifica um perfil antes de você confiar nele e Obter lista de modelos preenche os nomes dos modelos que os relatórios de endpoint (abrir o menu suspenso do modelo vazio também os busca). Você pode manter vários perfis e marcar um como padrão. A chave API é armazenada apenas no Windows Credential Manager; se não estiver disponível, a chave é mantida na memória para a sessão atual e inserida novamente na próxima vez.
Configure seu serviço de IA
Use a janela real de configurações de conexão para criar perfis com um endpoint, modelo e sua própria chave API. A captura de tela mostra um exemplo de endpoint local não salvo.
- Mantenha vários perfis e escolha um serviço padrão.
- As configurações avançadas incluem esforço de raciocínio, limites de saída e campos de solicitação extras.
- As chaves API usam o armazenamento de credenciais da plataforma. Você controla testes de conexão e solicitações de lista de modelos.
Cada resposta vem em três partes
O assistente pede ao modelo um formato fixo e divide a resposta à medida que ela chega. A precisão com que uma resposta segue o formato depende do modelo que você usa.
| Parte | O que contém |
|---|---|
| Explicação simples | O que a mudança faz e que efeito ela tem, com uma frase sobre o risco, escrita para quem não configura roteadores todos os dias |
| Detalhes técnicos | Versões RouterOS aplicáveis, pré-requisitos, o que foi alterado, como verificar e como reverter. Recolhido por padrão |
| Roteiro RouterOS | Somente comandos, colocados em um painel de script editável com destaque de sintaxe, um emblema de risco (Somente leitura, Alterações nas configurações ou Destrutivo) e uma contagem de bytes em relação ao limite do protocolo selecionado na janela principal |
Se uma resposta atingir o limite de saída, for interrompida ou deixar a seção do script aberta, o script será marcado como Incompleto. Se o modelo ignorar o formato, toda a resposta aparecerá nos detalhes técnicos e o primeiro bloco de código será usado como script. Com um modelo de raciocínio, um bloco Pensando recolhido acima da resposta mostra seu raciocínio à medida que chega; esse raciocínio não é mantido na conversa nem enviado de volta ao modelo. As explicações são escritas na linguagem da interface; os comandos permanecem em inglês. As perguntas de acompanhamento continuam a mesma conversa.
Material de referência: nenhum dispositivo ou exatamente um
Abra Assistente de IA no lado direito da tela inicial ou pressione Ctrl+I; seu menu ▾ abre as configurações de conexão AI. Várias janelas podem ser abertas. Faça perguntas gerais sobre o RouterOS ou escolha um instantâneo de configuração de um dispositivo como material de referência.
O instantâneo é obtido ao vivo com /export: somente leitura, com valores confidenciais ocultos e nenhum arquivo é criado no dispositivo. Isso funciona na conexão que WinBox usa (8291) e em SSH, e em API e REST em RouterOS 7 (RouterOS 6 não pode retornar a saída nesses dois). Em vez de buscar, você também pode carregar um .rsc local — por exemplo, um gravado pelo backup de configuração. Um .rsc local pode ser carregado com ou sem dispositivo.
O instantâneo é dividido em seções, como /ip firewall filter, e apenas as seções marcadas são enviadas. A janela mostra o tamanho e uma estimativa aproximada do token, avisa quando um modelo menor pode não caber nele e não enviará mais do que o limite de referência do perfil. Uma vez anexado, um instantâneo permanece com a conversa; para alterá-lo, inicie uma Nova conversa.
Da resposta à corrida, a decisão fica com você
O assistente de IA não possui botão Executar. Enviar para editor em lote abre ou apresenta a janela de lote separada, onde você revisa o script antes da execução.
-
Revise e edite
Edite o script no painel de scripts. O selo de risco e a contagem de bytes são atualizados conforme você digita.
-
Enviar para editor em lote
O script é colocado no editor em lote sob uma linha de comentários que nomeia a resposta, o dispositivo de referência e a hora. Ele é recusado — nunca truncado — quando o painel está vazio, quando um script incompleto não foi editado, quando excede o limite do protocolo atual ou enquanto um lote está em execução.
-
Escolha como ele pousa
Se o editor em lote já contém comandos, você escolhe Substituir ou Acrescentar. Se a seleção da janela principal não for apenas o dispositivo de referência, você escolhe entre selecionar apenas esse dispositivo e manter a seleção atual.
-
Execute você mesmo
Clique em Executar na janela Comandos em lote para enviar qualquer coisa. A classificação de risco, a confirmação do alvo e a confirmação digitada para comandos destrutivos ainda se aplicam. A substituição de um instantâneo pergunta primeiro se os resultados existentes seriam apagados.

Próximo: usando o assistente na prática
A documentação cobre a configuração de um perfil de conexão AI, a escolha do material de referência, exatamente o que é enviado, a leitura de uma resposta e o envio do script para o editor em lote.