
Característica
Una IA que lee su dispositivo antes de responder
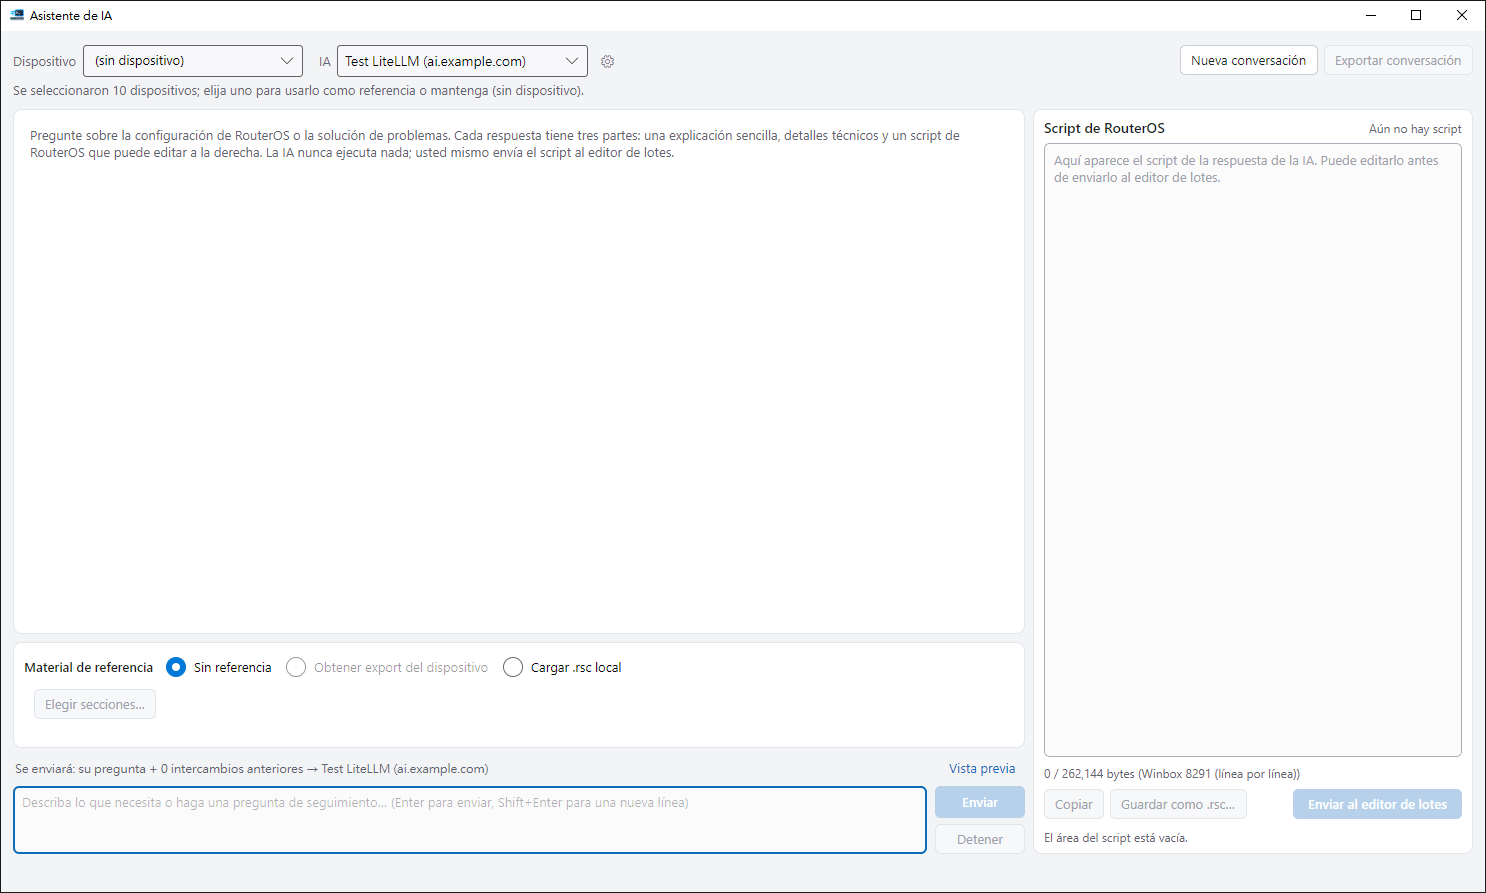
Conecte un dispositivo y la IA lee primero su configuración, luego responde por ese dispositivo (sus interfaces reales, direcciones y versión RouterOS) en lugar de un ejemplo genérico. Obtiene una explicación sencilla, los detalles técnicos y un script editable. El asistente nunca ejecuta nada: usted revisa el script y lo ejecuta usted mismo.

La diferencia: ha visto este dispositivo
Abra Asistente AI desde el lado derecho de la pantalla de inicio o presione Ctrl+I. Su menú ▾ abre la configuración de conexión AI. Se pueden abrir varias ventanas de asistente, sin ningún dispositivo de referencia ni una instantánea de exportación de la configuración de un dispositivo.
- Ve este dispositivo: un
/exportde solo lectura, sin ningún archivo creado en el dispositivo; tú eliges qué secciones se envían. - Conoce la versión: se le indica si el dispositivo ejecuta RouterOS 6 o 7 y escribe comandos para él.
- Un script que puedes consultar: el script de la derecha puede usar los nombres de interfaz de este dispositivo y conlleva un nivel de riesgo; cuando se vea bien, elija Enviar al editor por lotes.
Tu servicio de IA, tu clave
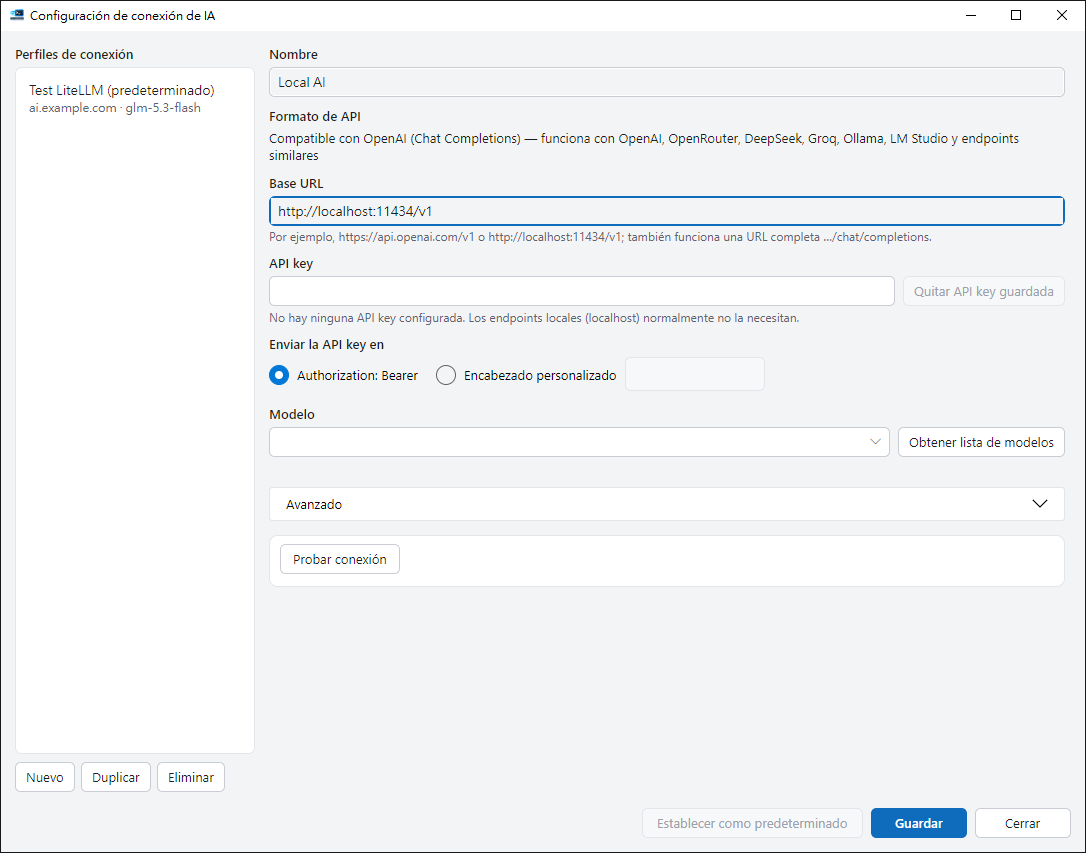
RosRunner no incluye un servicio de IA propio y no tiene un punto final integrado. Usted crea un perfil de conexión de IA (una URL base, un modelo y, para la mayoría de los servicios en la nube, una clave API) y el asistente envía sus preguntas allí y a ningún otro lugar. La aplicación no envía telemetría.
Esta versión admite un formato API: Chat Completions compatible con OpenAI. Lo ofrecen servicios como OpenAI, OpenRouter, DeepSeek, Groq y Mistral, y tiempos de ejecución locales como Ollama, LM Studio y vLLM, donde el modelo se ejecuta en su propia computadora y no se necesita clave. Un perfil también puede nombrar un encabezado de clave diferente, agregar encabezados adicionales y una cadena de consulta, apuntar a una URL de lista de modelos separada y fusionar campos de solicitud adicionales (un objeto JSON) en el cuerpo de la solicitud, para puntos finales como las puertas de enlace OpenAI, Ollama y API de Azure que los esperan. Esfuerzo de razonamiento (enviado como reasoning_effort, Bajo para perfiles nuevos) evita que los modelos de razonamiento piensen más de lo necesario para la pregunta. Los servicios nombrados aquí son ejemplos del formato, no una lista de compatibilidad probada.
Probar conexión comprueba un perfil antes de confiar en él y Obtener lista de modelos completa los nombres de los modelos que informa el punto final (al abrir el menú desplegable de modelos vacío también se obtienen). Puede conservar varios perfiles y marcar uno como predeterminado. La clave API se almacena únicamente en Windows Credential Manager; si no está disponible, la clave se guarda en la memoria para la sesión actual y se ingresa nuevamente la próxima vez.
Configure su servicio de IA
Utilice la ventana de configuración de conexión real para crear perfiles con un punto final, un modelo y su propia clave API. La captura de pantalla muestra un ejemplo de punto final local no guardado.
- Mantenga varios perfiles y elija un servicio predeterminado.
- Las configuraciones avanzadas incluyen esfuerzo de razonamiento, límites de salida y campos de solicitud adicionales.
- Las claves API utilizan el almacén de credenciales de la plataforma. Usted controla las pruebas de conexión y las solicitudes de lista de modelos.
Cada respuesta viene en tres partes.
El asistente pregunta al modelo un formato fijo y divide la respuesta a medida que llega. El grado de exactitud con que una respuesta sigue el formato depende del modelo que utilice.
| parte | que contiene |
|---|---|
| explicación sencilla | Qué hace el cambio y qué efecto tiene, con una frase sobre el riesgo, escrita para alguien que no configura enrutadores todos los días |
| Detalles técnicos | Versiones aplicables de RouterOS, requisitos previos, qué se cambia, cómo verificarlo y cómo revertirlo. Contraído por defecto |
| Guión RouterOS | Solo comandos, ubicados en un panel de script editable con resaltado de sintaxis, una insignia de riesgo (solo lectura, cambios de configuración o destructivo) y un recuento de bytes respecto al límite del protocolo seleccionado en la ventana principal. |
Si una respuesta alcanza el límite de salida, se interrumpe o deja abierta la sección del script, el script se marca Incompleto. Si el modelo ignora el formato, la respuesta completa aparece debajo de los detalles técnicos y el primer bloque de código se utiliza como script. Con un modelo de razonamiento, un bloque de Pensamiento colapsado encima de la respuesta muestra su razonamiento a medida que llega; ese razonamiento no se mantiene en la conversación ni se envía de vuelta al modelo. Las explicaciones están escritas en el idioma de la interfaz; Los comandos permanecen en inglés. Las preguntas de seguimiento continúan la misma conversación.
Material de referencia: ningún dispositivo, o exactamente uno
Abra Asistente AI en el lado derecho de la pantalla de inicio o presione Ctrl+I; su menú ▾ abre la configuración de conexión AI. Se pueden abrir varias ventanas. Haga preguntas generales sobre el RouterOS o elija una instantánea de la configuración de un dispositivo como material de referencia.
La instantánea se recupera en vivo con /export: solo lectura, con valores confidenciales ocultos y no se crea ningún archivo en el dispositivo. Esto funciona sobre la conexión que usa WinBox (8291) y sobre SSH, y sobre API y REST en RouterOS 7 (RouterOS 6 no puede devolver la salida sobre esos dos). En lugar de recuperarlo, también puede cargar un .rsc local, por ejemplo uno escrito mediante una copia de seguridad de la configuración. Se puede cargar un .rsc local con o sin dispositivo.
La instantánea se divide en secciones, como /ip firewall filter, y solo se envían las secciones que usted marca. La ventana muestra el tamaño y una estimación aproximada del token, advierte cuando es posible que un modelo más pequeño no se ajuste y no enviará más que el límite de referencia del perfil. Una vez adjunta, una instantánea permanece con la conversación; para cambiarlo, inicia una Nueva conversación.
Desde la respuesta hasta la ejecución, la decisión permanece contigo
El asistente AI no tiene botón Ejecutar. Enviar al editor por lotes abre o muestra la ventana por lotes independiente, donde se revisa el script antes de su ejecución.
-
Revisar y editar
Edite el script en el panel de script. La insignia de riesgo y el recuento de bytes se actualizan a medida que escribe.
-
Enviar al editor por lotes
El script se coloca en el editor por lotes debajo de una línea de comentario que nombra la respuesta, el dispositivo de referencia y la hora. Se rechaza (nunca se trunca) cuando el panel está vacío, cuando no se ha editado un script incompleto, cuando excede el límite del protocolo actual o mientras se ejecuta un lote.
-
Elige cómo aterriza
Si el editor por lotes ya contiene comandos, elija Reemplazar o Agregar. Si la selección de la ventana principal no es solo el dispositivo de referencia, puede elegir entre seleccionar solo ese dispositivo o mantener la selección actual.
-
Ejecútelo usted mismo
Haga clic en Ejecutar en la ventana de comandos por lotes para enviar cualquier cosa. La clasificación de riesgos, la confirmación de objetivos y la confirmación escrita para comandos destructivos aún se aplican. Al reemplazar una instantánea, primero se pregunta si se borrarán los resultados existentes.

Siguiente: usar el asistente en la práctica
La documentación cubre la configuración de un perfil de conexión de IA, la elección del material de referencia, exactamente qué se envía, la lectura de una respuesta y el envío del script al editor por lotes.